
AIアート万能プロンプト公式:被写体+ディテール+スタイル+パラメータ、初心者向け4パート分解
AIアート万能プロンプト公式は「被写体+ディテール+スタイル+パラメータ」の4パート構成です。まず核となる被写体を1つ固定し、環境・動作・光・質感で肉付けし、スタイルでトーンを定め、最後に品質・構図・レンダリングエンジン・ディテール精細度で仕上げます。この順序に沿えば、初心者でも一発で画像を生成できます。
このガイドで得られること
万能公式はどんな形?:4パート構成を一文で理解する
Puyo AIに初めて触れるとき、多くの人が同じ経験をします。頭の中では絵がはっきり見えているのに、入力欄の前で書き出せず、慌てて数行タイプしたら、生成された画像は想像と大きくズレる——「言える」と「作れる」の間の溝は、美的センスの問題ではなく、プロンプトの表現ロジックにあります。
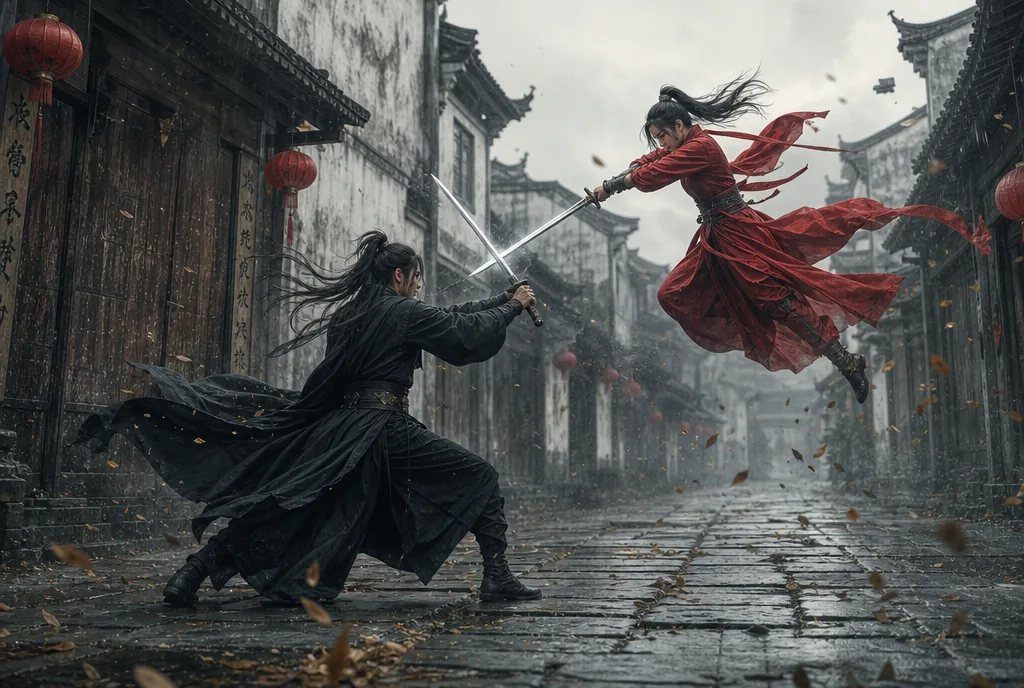
必要なのはたった一つの公式、被写体+ディテール+スタイル+パラメータです。これは翻訳キーのように働き、頭の中の漠然としたイメージを、AIが解釈できる構造化された指示文に変換してくれます。被写体は「何を描くか」を固定し、ディテールは「どんな姿か」を具体化し、スタイルは「どんなトーンか」を決め、パラメータが「鮮明さと構図」を仕上げます。4パートで4つの役割——書く前にセクション分けし、各セクション1文ずつ書けば十分です。まずは公式をフルに使った生成例を見てください:
被写体の書き方:アンカーが曖昧だと画像全体がズレる
被写体は画像全体の核となるアンカーで、以降のディテール・スタイル・パラメータはすべてこれを軸に回ります。被写体を書く第一ステップは基本カテゴリの設定——人か、動物か、物か。第二ステップは中核的特徴で輪郭を狭めること——存在状態、機能属性、構造的特徴。この2ステップで「抽象的なカテゴリ」が「具体的な対象」に変わります。
大雑把な被写体ときちんと定義された被写体の差はどれほど?同じツール・同じモデルでの比較を見てください:
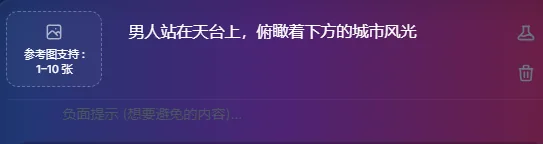
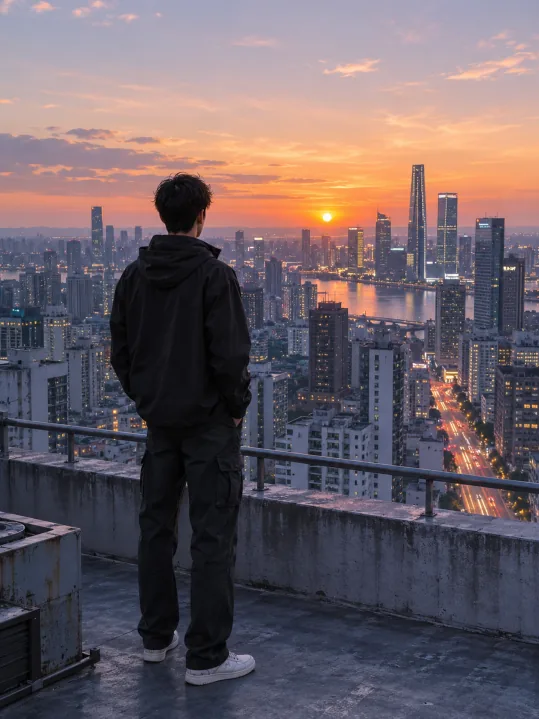
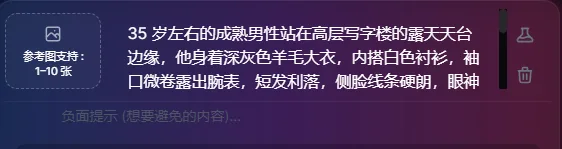
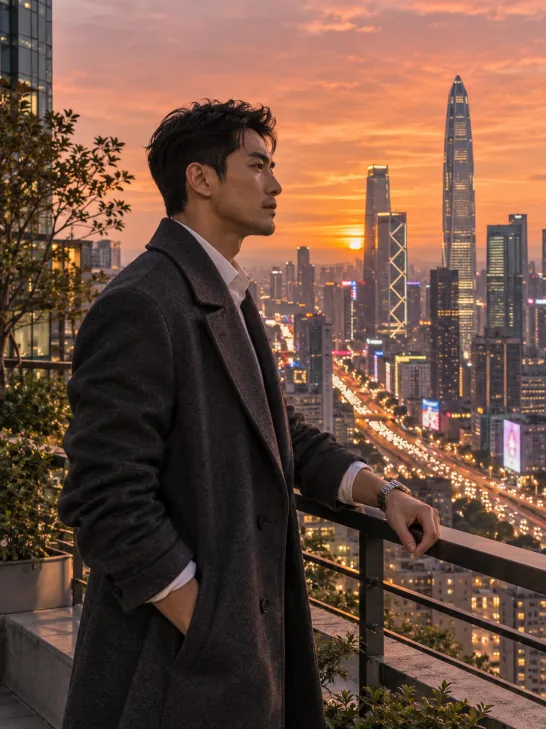
図1-1 一文と一段落、被写体説明の差が生む出力の違い
基本カテゴリと中核的特徴を決めたら、3つの補助軸もお忘れなく:視点は見せ方のアングルを、スケールは被写体が画面に占める割合を、場面との関係は置かれる環境を決めます。3つとも被写体そのものには属しませんが、構図を直接左右します——プロンプトはほぼ同じで視点だけ変えただけで、まったく異なる2つの印象が生まれます:
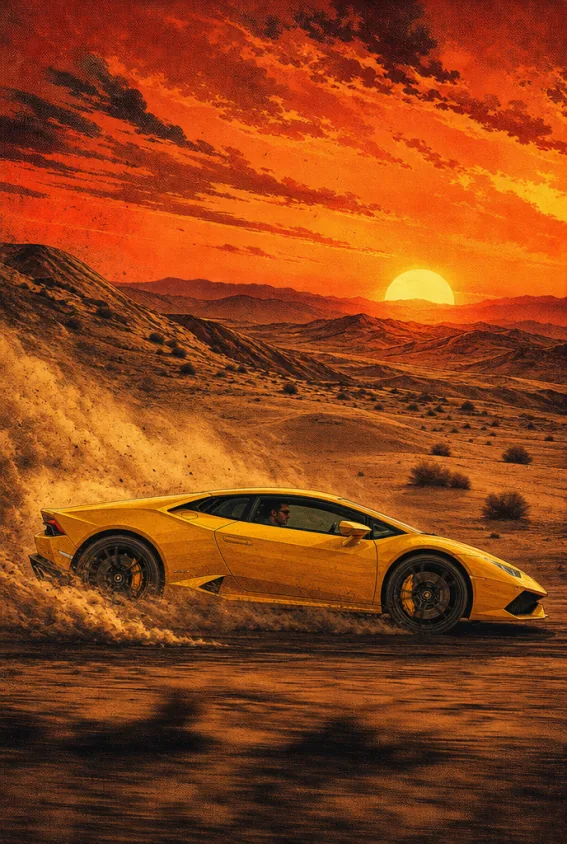
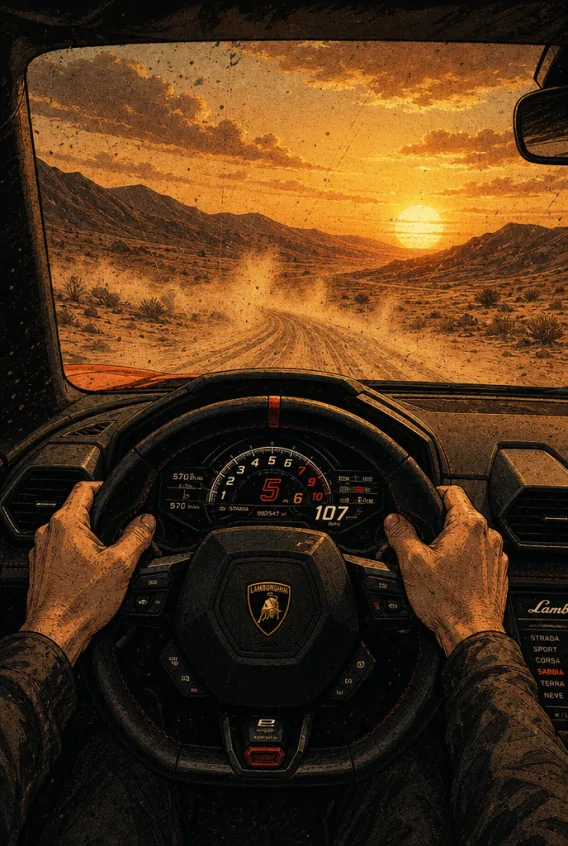
図1-2 視点を変えるだけで絵の語りが変わる
被写体を書くときの落とし穴は2つ、どちらかに足を踏み入れればほぼ確実にズレます。1つ目は曖昧な表現:「美人」「高級感」「あの感じ」といった主観的な言葉で被写体を描写すると、AIには共通の基準がなく、推測するしかありません。2つ目は複数被写体:一文で女の子と猫と城を同時に要求すると注意が分散し、画面要素のバランスが崩れて焦点が死にます。正解は一行に集約されます:客観的・具体的に、一度に核となる被写体はひとつだけ。
ディテール語彙の使い方:環境・動作・光・質感
被写体が骨格なら、ディテールは肉付けです。初心者は膨大な語彙を暗記する必要はなく、4つの軸を押さえて各軸1文ずつ書けば十分です。
第1の軸は環境:被写体はどこにいるのか。空間属性・天候状態・場面の雰囲気を3層で押さえます——たとえば「雨に洗われた江南の古い街並みの通り」の一文で、空間・天気・情緒を一気に囲めます。環境が曖昧だと、被写体はシールのように背景の上に浮いて見えます。
第2の軸は動作:絵を動かします。四肢の状態・動作の方向性・インタラクションで構成します。静止画が一番嫌うのは硬さ——「剣を掲げて跳ぶ」「しゃがんで猫を撫でる」のような方向性のある動詞は、どんな形容詞よりも効きます:
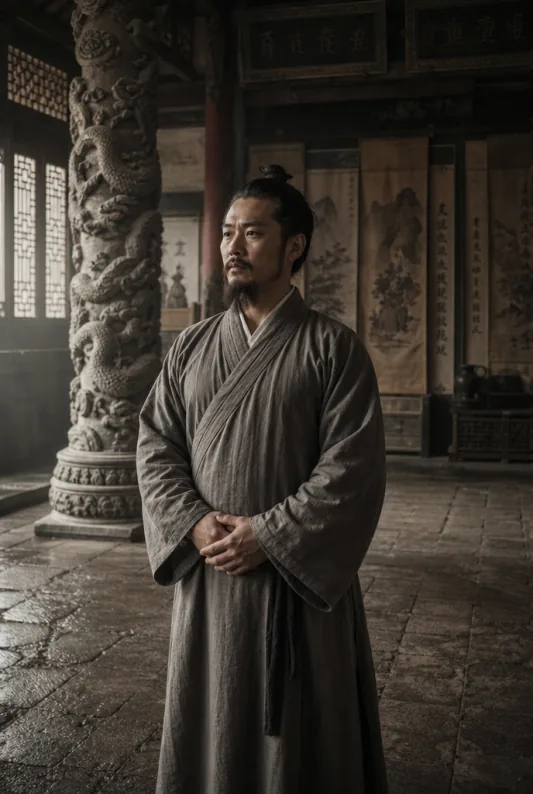
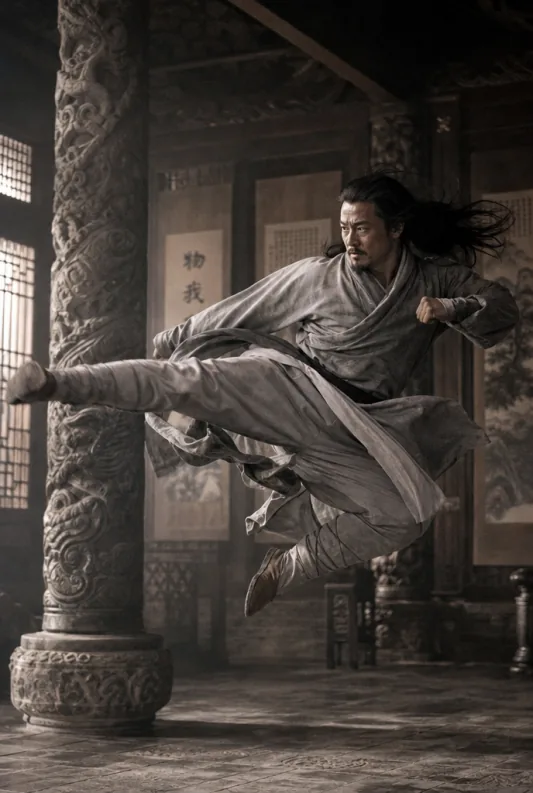
図1-3 被写体に動作を与えると語りが一気に変わる
第3の軸は光:階層と雰囲気を決めます。光の種類・演出・強さを指定します——たとえば「夕暮れのサイド逆光、暖かい長い影」。同じ被写体でも、光が変われば情感のキーが変わります:
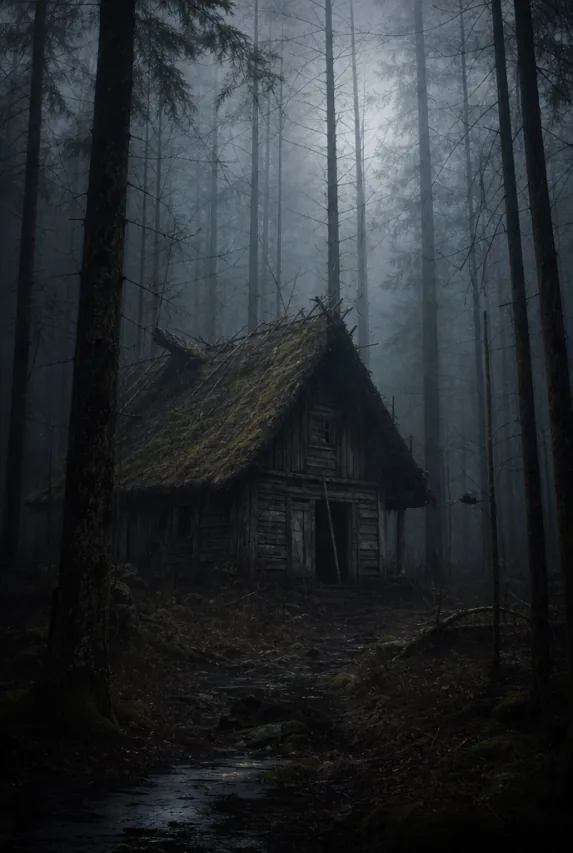
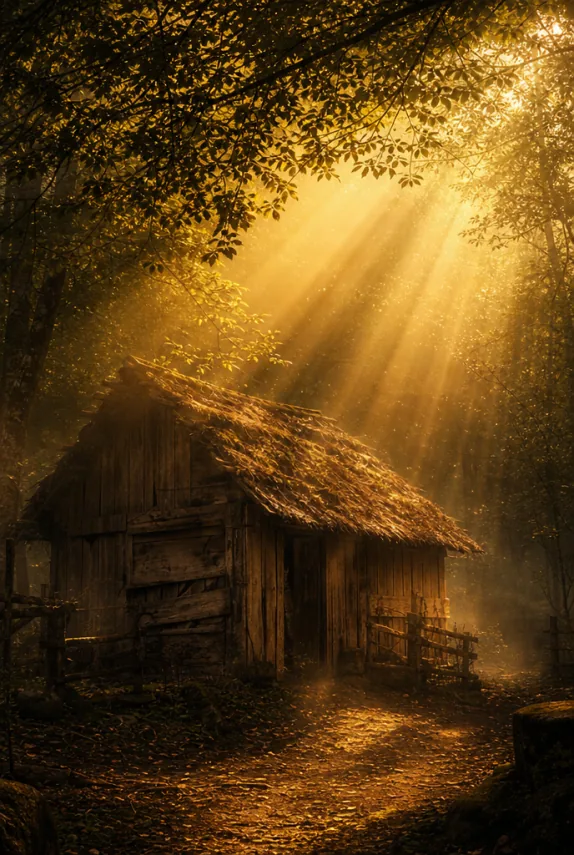
図1-4 光は絵の雰囲気スイッチ
第4の軸は質感:リアリティを最大化します。布・金属・自然物を分けて描写します——セーターの柔らかな毛糸の質感、鎧の金属反射、樹皮のざらついた粒立ち。「セーターの毛糸の1本1本まで見える」は「高画質」の2語よりはるかに効きます:
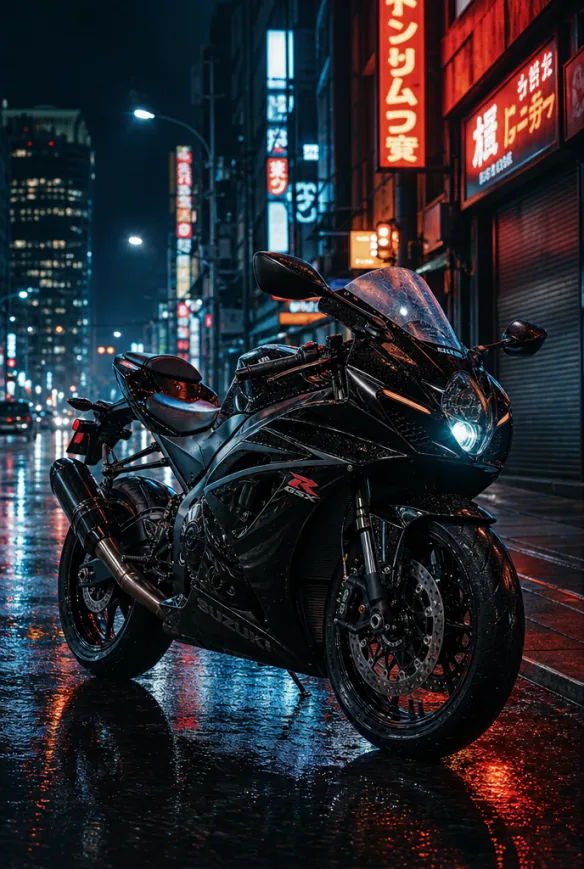
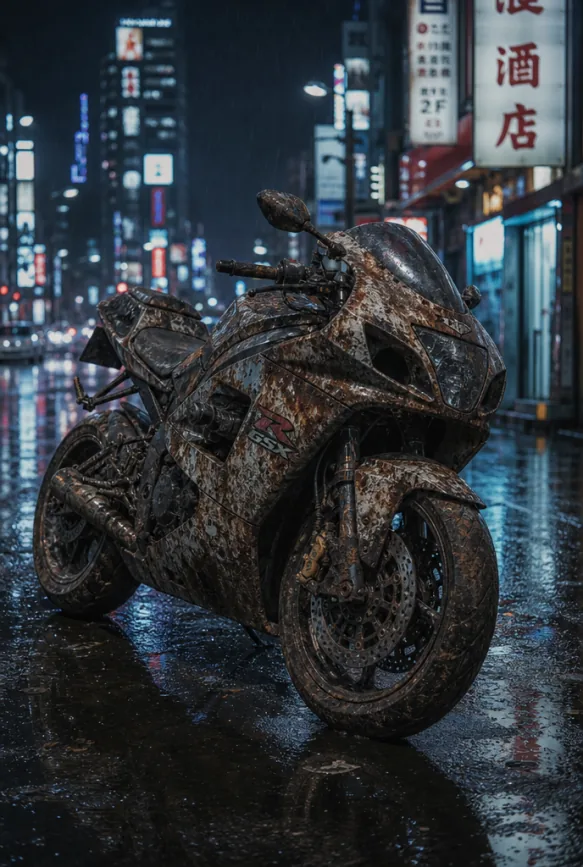
図1-5 質感描写で絵は「見える」から「触れそう」へ
環境・動作・光・質感が連携して、抽象的なアイデアを実行可能な視覚指示に変えます。「被写体 → 環境 → 動作 → 光 → 質感」の順に一通り点検し、抜けている部分を補えば、完全なプロンプトが完成します。
おわりに:公式をどう練習し続けるか
公式を暗記しただけでは習得とはいえません——練習が必要です。すぐ埋めて使える4パートのスケルトンを英語で1つ用意しました。括弧内を自分のアイデアに差し替えれば、そのまま生成できます:
[被写体]+[環境・アクション・ライティング・質感をそれぞれ1文ずつ]+[スタイル、例:フォトリアル(写実)スタイル]+[パラメータ、例:映画級の品質、超高精細ディテール、黄金比率構図]
スケルトンプロンプト:セクションごとに空欄を埋め、通読して重複する語を削除してから、生成画面に貼り付けてください。
次の段階は絵のトーンを決めること——スタイルの選び方とパラメータの調整方法は、第2回のAIアートのスタイルとパラメータの選び方でさらに分解して解説します。いきなり完全な事例を試したい人は、第3回のはじめてのAIアートプロンプトの書き方へ。ゼロから推敲までの全記録をまとめています。
FAQよくある質問
このガイドについて、初心者が最もよく聞く質問
万能プロンプト公式は4パートすべて書く必要がありますか?
必ずしもそうではありません。4パートすべて書いた結果が最も安定しますが、アイデアの素早い検証なら「被写体+スタイル」だけでも画像は出ます——被写体が基準線で、これがなければAIは自由に即興し、結果はほぼ制御不能です。
プロンプトは中国語と英語、どちらで書くべき?
どちらでも構いません。Puyo AIは中国語と英語の両方のプロンプトを認識します。同じプロンプトの中国語版と英語版で意味を一致させておけばOKです。迷ったら、まず4パートを中国語ではっきり書いてから英語に訳すとよいでしょう——鍵は言語ではなく、構造の完全さです。
同じプロンプトで毎回違う画像が出るのは正常?
はい、正常です。生成にはランダム性があるため、同じプロンプトを2回回すのはよくあること。2回ともズレたら運任せに賭けるのではなく、被写体の説明が明確かどうかに立ち戻って確認しましょう。
被写体とディテールの順序を入れ替えてもいい?
入れ替えないほうがよいでしょう。被写体を先に置くことでAIは先に核となる対象を固定し、ディテールが後から輪郭を整えます。順序が崩れると、生成結果が期待からズレる頻度が目に見えて上がります——詳細はPrompt Engineering – Wikipedia↗を参照。
ディテールは多ければ多いほどよい?
いいえ。各軸の正確な1文で十分です。語を積み重ねると画面要素のバランスが崩れます。まず環境・動作・光・質感の4軸をカバーし、必要に応じて雰囲気語を1〜2個足す程度に。
プロンプトは段落に分けて書くべき?
分ける必要はありません。1つのまとまった指示文として書けば、AIが意味で4パートを識別します。自分で下書きするときだけ4パートを列挙し、入力の際に1段落へ統合すればよいのです。
著者について:Julia|ベテランAI画像クリエイター
Juliaはアバター、イラスト、実務図解、キャラクターデザインなどでAI画像ツールを長年活用し、多くの完全初心者を指導してきました。本記事の事例・プロンプト・パラメータ・スクリーンショットは、すべてPuyo AIプラットフォームでの実際の生成記録に基づいています——理論上の推測でも、寄せ集めのストック素材でもありません。本記事はシリーズ第1回(公式の総括ガイド)です。第2回ではスタイルとパラメータの選び方を続けて解説します。
本コンテンツは原本資料「初心者からAIアートのプロへ|完全実践チュートリアル集」を加筆・整理したもので、オリジナルのプロンプトと図版はすべてそのまま残しています。出典:https://www.puyoai.com。
公式はすでにあなたの手の中
Puyo AIのサイトを開き、4パートの公式に沿って最初のプロンプトを書き、このガイドの解説を見ながら確認してみてください。
生成結果はモデルのバージョンとランダム性の影響を受けます。同じプロンプトでも実行のたびに結果は多少異なるため、数回回してから判断してください。